
El 1 de octubre de 2026, Google publicó una nueva versión de su documentación sobre cómo crear contenido útil. Contiene dos cambios importantes. Uno se refiere a los cuatro criterios principales que aplican para diferenciar entre contenido de calidad del que no lo es. El otro, más específico, aclara que falsear la identidad del autor del contenido es una señal inequívoca de baja calidad.
En este post explico los cambios y muestro que no reflejan un giro en la postura de Google en esta materia, sino que es una manera de sintetizar y comunicar más claramente lo que venían diciendo durante años a través de su guía para evaluadores de calidad.
¿Qué es la calidad del contenido para Google?
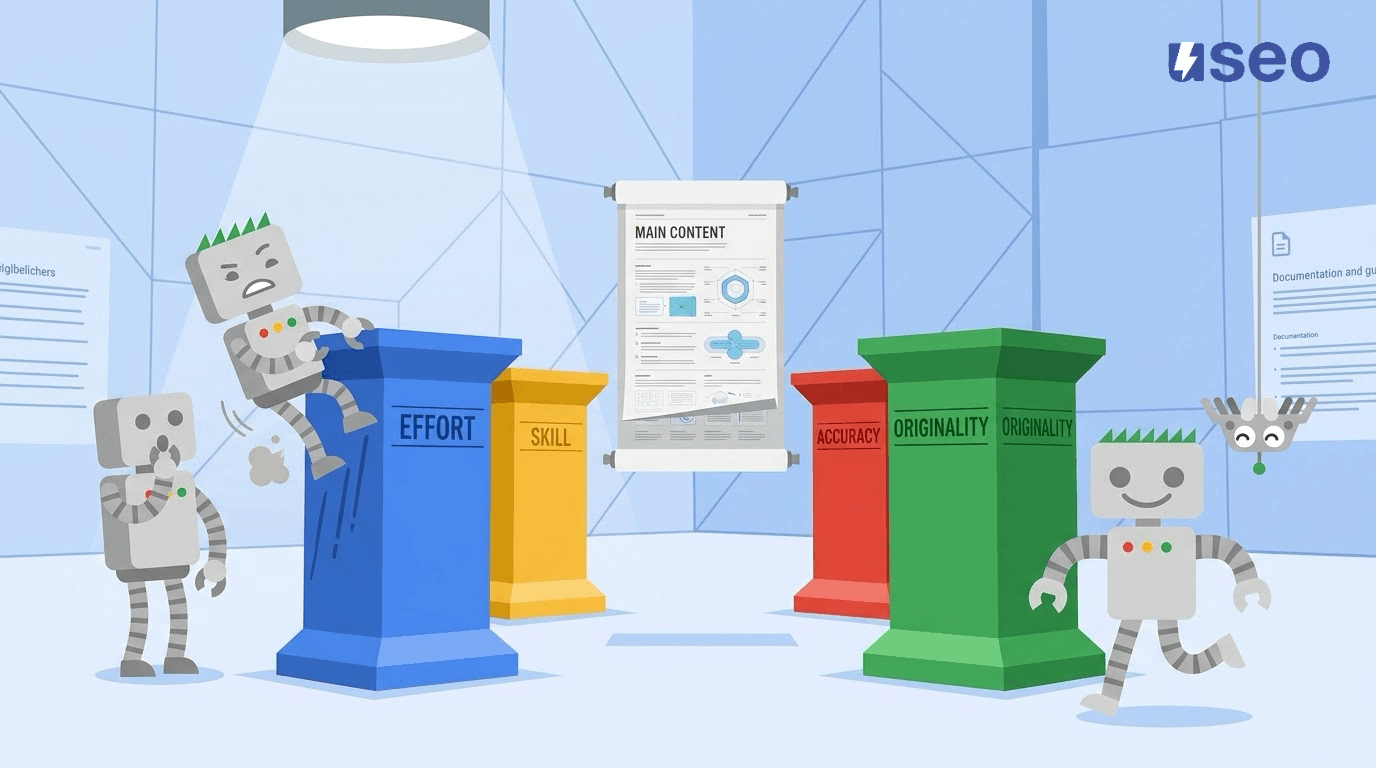
Según Google, la calidad de un contenido puede determinarse por la cantidad de esfuerzo, originalidad, talento o habilidad y exactitud que una persona ha puesto para crear ese contenido. Estos son los 4 pilares de la calidad de contenido para Google, de los que hablaremos más adelante.
¿En qué parte del contenido se fija Google? El contenido principal
Para determinar la calidad del contenido de una página web, Google se fija ante todo en lo que llaman contenido principal (Main Content). Se trata de aquellas partes de la página que contribuyen directamente a que la página cumpla su cometido principal (ya sea informar o vender algo).
Los elementos que pueden formar parte del contenido principal son el titular de la página y sus encabezados, el texto principal de una página (lo que estás leyendo ahora mismo), las imágenes que acompañan a ese texto, los elementos interactivos, los comentarios de los usuarios e incluso las pestañas con contenido expandible (como por ejemplo especificaciones de producto).
Por tanto, quedarían fuera del contenido principal de una página elementos como los menús de navegación, anuncios, widgets de contenido relacionado o popular, botones para compartir en redes sociales, etc. Si tenéis dudas, todo esto está perfectamente delimitado, con ejemplos, en la guía para evaluadores de calidad (páginas 13 y 14).
Los 4 pilares de la calidad de contenido
Google explica en su nueva documentación que para estimar la calidad de un contenido piden a sus evaluadores que se fijen fundamentalmente en 4 criterios:
1. Esfuerzo (Content Effort): es el grado en el que se ha empleado trabajo humano para elaborar el contenido, o los sistemas que lo impulsan. Dicho simplemente, es lo contrario del copia y pega. Por ejemplo, un análisis original sobre cualquier tema, traducir con tus propias palabras un poema o crear de cero un mapa interactivo son ejemplos de contenido que ha requerido esfuerzo.
Dicho esto, a cualquiera se le ocurre que pedirle a ChatGPT o la IA de turno que haga el trabajo, y pegarlo en tu página tal cual sale del chatbot, no es en ningún caso una muestra de esfuerzo por parte del creador. A buen entendedor…
Y una nota importante: aunque cites o atribuyas el trabajo de otros de manera adecuada, si todo lo que estás haciendo es copiar o trasladar lo que han dicho otros, eso sigue sin demostrar esfuerzo. Tienes que aportar algo propio.
2. Originalidad. Aportar información original o perspectivas únicas sobre un tema. Si publicas lo mismo que ya está publicado en otras páginas webs, tal cual y sin aportar nada extra, tu contenido tiene cero originalidad.
3. Talento o habilidad. Es el grado en el que el autor del contenido demuestra dominar su tema o área de conocimiento lo suficiente como para dar una experiencia satisfactoria a los que consumen el contenido. Un signo externo de esta habilidad es comunicar el tema de manera clara, ya sea por escrito o con un vídeo bien hecho.
Google hace aquí la aclaración obvia de que no todos los temas requieren un grado de habilidad sobresaliente para satisfacer al usuario. Para saber cómo cambiar la rueda de una bicicleta, no necesitas que la explicación venga de un mecánico en un equipo de la élite profesional.
4. Exactitud (Accuracy). La información presentada por el contenido debe ser correcta. No puede ser considerado de calidad una página que contiene datos incorrectos o inventados. En el caso de las temáticas YMYL (aquellas que pueden afectar a la salud o al bolsillo de los lectores), este criterio cobra especial importancia: este tipo de contenidos deben tener la mayor exactitud posible y estar de acuerdo con el consenso científico.
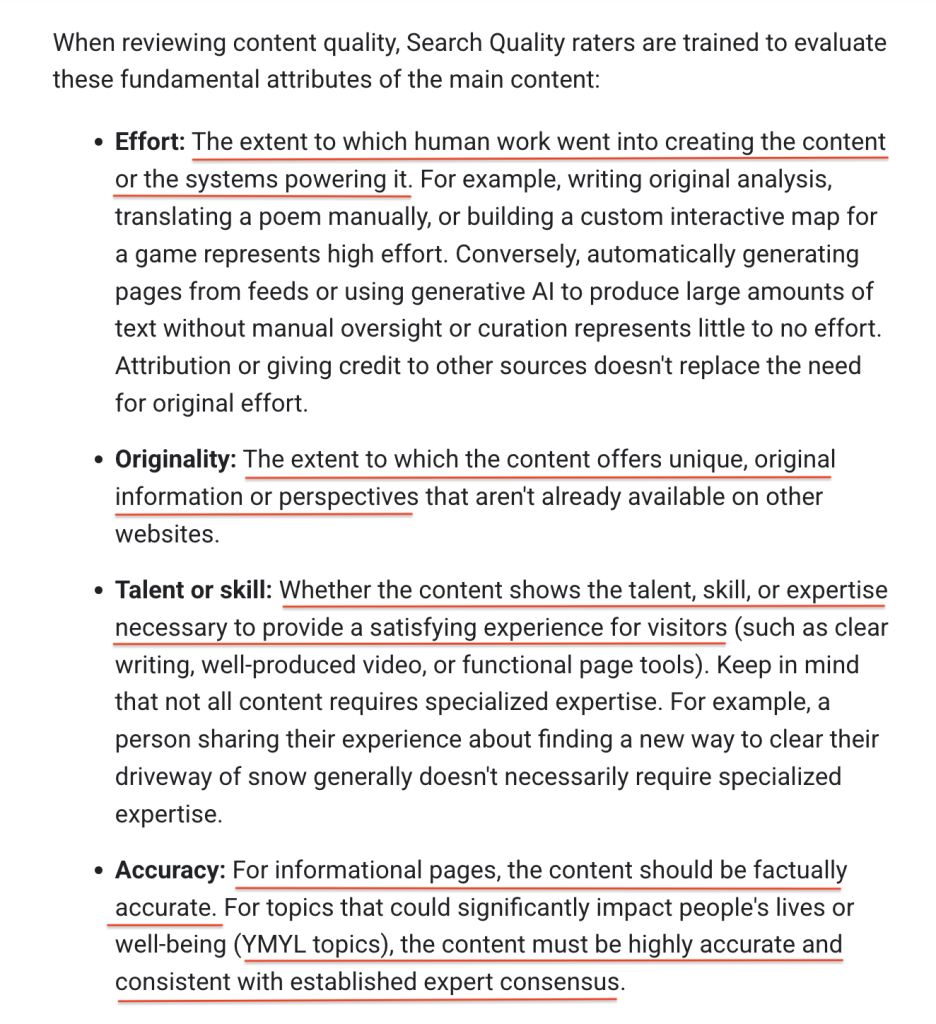
Los 4 criterios de calidad de contenido en la guía para evaluadores
Ninguno de los 4 pilares es un concepto nuevo en las comunicaciones de Google, aunque hasta ahora no habían sido definidos como tal en la documentación de Search.
El documento que mejor nos sirve para comprender cómo han ido creciendo en importancia estos criterios dentro de Google (al menos en su comunicación de puertas hacia fuera) es la guía para evaluadores de calidad de Google. En su primera versión, de 2012, el concepto effort aún no aparecía mencionado, pero la versión de noviembre de 2015 lo mencionaba 34 veces.
Siete años después, en diciembre de 2022, effort tenía ya 101 menciones dentro de la guía (hoy va por 120) y sobre todo, aparecía por primera vez esta tabla, que es básicamente la misma forma de explicar los criterios que se ha añadido ahora a la guía de contenido útil:
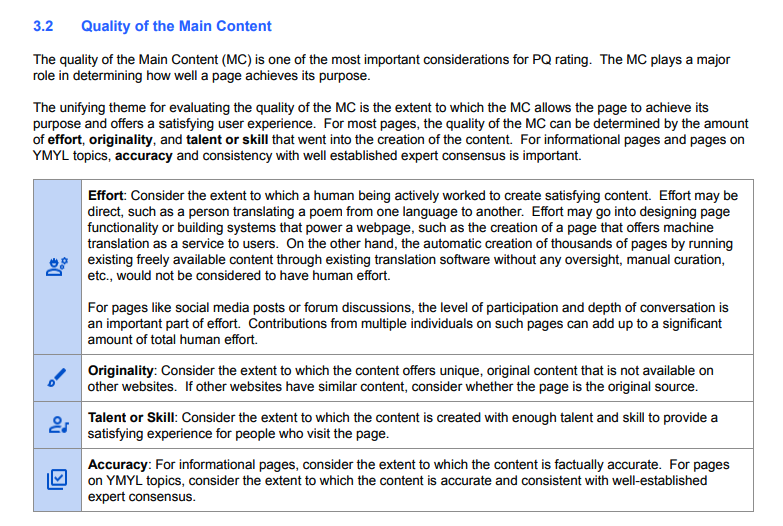
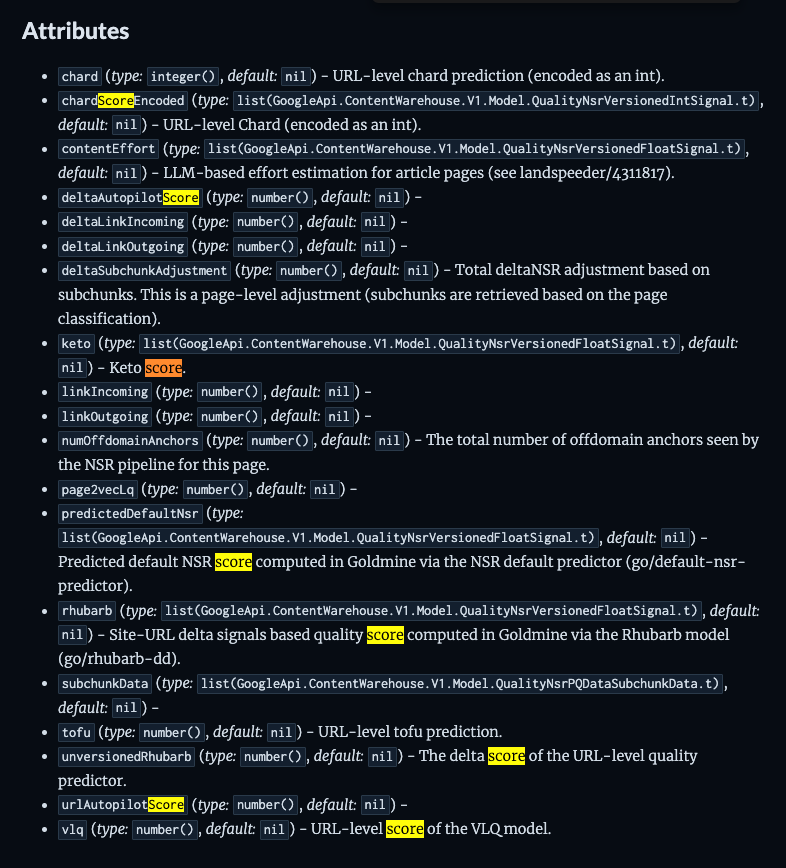
Esfuerzo no sólo tiene la definición más extensa. Es de los 4 el concepto más repetido a lo largo de la guía, y es el único, que sepamos, que aparece mencionado tal cual en la filtración de documentación interna de Google de mayo de 2024, donde aparece un atributo llamado contentEffort, dentro de lo que parece ser un cálculo de calidad a nivel de página (Model.QualityNsrPQData).
¿Su descripción? Una «estimación de esfuerzo para páginas de tipo artículo, basada en LLMs». Es decir, que dentro de ese algoritmo o sistema, no es una persona la que asigna una puntuación de esfuerzo, sino un LLM, haciendo las veces de evaluador de calidad, método que sabíamos que los buscadores usaban desde que Bing publicó este paper.
En resumen, tenemos estos 3 hechos:
- que Google lleva algo más de diez años pidiendo a sus evaluadores humanos que se fijen en el esfuerzo y en los otros 3 criterios para evaluar la calidad de una página,
- que desde 2022 explica a sus evaluadores cómo estimar la calidad en exactamente los mismos términos que ahora ha plasmado en su documentación pública,
- que en 2024 Google tenía ya una forma automatizada de estimar el esfuerzo de un contenido, y que formaba parte de un sistema más amplio para puntuar o evaluar algorítmicamente diversos aspectos de una página (sistema que lleva las siglas PQ – no creo que imaginar que esas siglas significan Page Quality sea tirarse a la piscina-, y donde la palabra score aparece en 8 de sus atributos).
¿Por qué es importante todo esto para SEO?
A lo largo de los 13 años que llevo en SEO, una de las quejas más frecuentes contra Google era que Google recomienda hacer contenido de calidad, pero no define correctamente qué consideran calidad. Como he explicado, desde el momento en el que la guía de evaluadores de calidad ya definía estos criterios, la queja dejaba de tener gran parte de sentido.
Pero se podía objetar que ese documento de Google, de casi 200 páginas, no era ni mucho menos una lectura accesible, y de hecho es un poco absurdo pedirle a cada creador de contenido y dueño de pequeños negocios del mundo que se lea el mismo documento que Google prepara para personas a las que paga por hacer el trabajo de evaluar contenidos.
Obviamente, tiene más sentido tener una documentación mucho más sintética y al grano, que destile los conceptos más importantes que cualquiera debe conocer si no quiere ser objeto de una penalización o simplemente de no alcanzar visibilidad en Google.
El texto actual de su documentación sobre contenido útil me parece la versión más clara y concreta hasta la fecha. Pero, por supuesto, es necesario que Google aplique sus criterios, una vez publicados y explicados de manera clara.
Hay quien dice que Google comunica mucho y luego sus algoritmos plasman poco esa misma comunicación. No soy de la misma opinión. Creo que es cierto que algunas políticas llegan a las páginas de resultados bastante después que su comunicación pública, pero acaban llegando.
Incluso muchas veces, cuando llegan, lo que más se oye es la queja contraria: que Google se ha pasado aplicando lo que avisaba. Panda, Medic Update, Helpful Content Update… son todos ellos algoritmos ligados a la calidad del contenido y donde la sensación general fue que Google había actuado con bastante dureza. ¿Que meses después seguimos viendo spam? Sí, y por eso los updates de Google nunca paran.
No hay un algoritmo 100% efectivo, y aunque lo hubiera, sería sólo por un breve momento, ya que la web está en constante movimiento y lo están también las formas de manipular y/o aprovecharse de los algortimos.
Pero sí es cierto que de vez en cuando (en ciclos de al menos 2-3 años) suele haber un update que marca un antes y después en la ejecución de sus políticas. Y con frecuencia han venido después de una actualización extensa de sus guías y páginas de documentación. A buen entendedor…
Qué opina Google sobre falsear el autor de una página
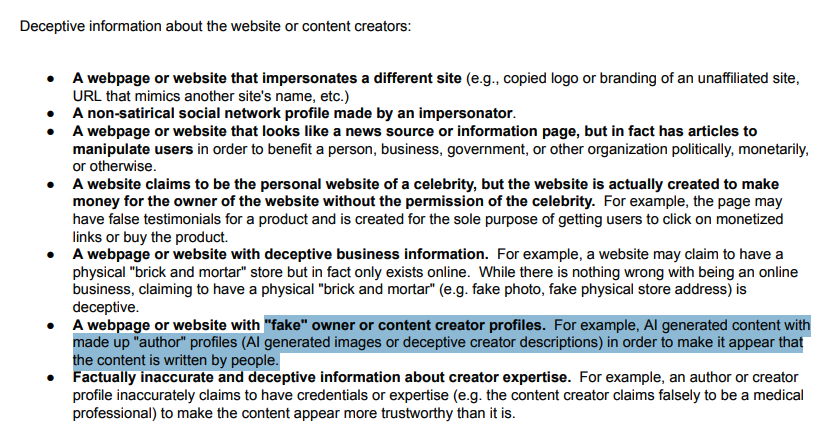
La otra novedad de la documentación habla sobre la autoría de la página. Anteriormente ya había un párrafo dedicado a «quién» crea el contenido. En él se estipulaba que era recomendable incluir quién firma el contenido, si se trataba del tipo de contenido donde los lectores esperan ver el nombre del autor. Ahora Google añade que en ningún caso se debe engañar, ni «inventar» una identidad para atribuirle la autoría del contenido, y que esa forma de engaño supone que Google considerará la página como de baja calidad.
¿Qué constituye un engaño respecto a quién es el autor del contenido, según Google? Usar nombres falsos, generar con IA fotos de personas inventadas, o exagerar o falsear las credenciales de una persona para dar la sensación de que es experto en un tema, o que tiene más experiencia de la que realmente tiene.
Todo esto, que parece de sentido común, no ha impedido que en los últimos años hayamos visto numerosos casos en medios (en ocasiones incluso medios de gran reputación), sobre todo usando autores inventados para firmar páginas generadas por IA. Por esta razón, Google ha tenido que añadir este párrafo que aclara que no quiere ver una firma sin más, sino que la firma sea realmente de la persona que ha creado el contenido y, si el tema lo merece, que la persona que ha creado y firma sea realmente experta y sepa de lo que habla.
De nuevo, esto es algo que ya aparecía en la última versión de las Quality Rater Guidelines, en prácticamente los mismos términos que ahora en la documentación:
En definitiva: poner una firma por poner, o autonombrarte experto cuando no lo eres, es un hack con patas muy cortas, y que tanto para tus usuarios como para Google, acaba siendo peor, una vez que se descubre el engaño.
Relación de estos cambios con el contenido generado por IA
En los últimos años, cada vez que Google se pronuncia sobre algo, una de las cosas que más preocupa al público es si Google opina que es válido usar IA para generar contenido o no. En el caso de la última actualización de su documentación, el mensaje parece claro: usa la IA generativa como una herramienta más para ayudarte a producir tu contenido, pero no uses el output de una IA como el contenido en sí, sin ningún tipo de supervisión o curación por tu parte, y sobre todo no la uses para producir contenido a escala o en masa, ya que el contenido a escala (hablamos de miles de páginas) y sin supervisión suele ser incompatible con los 4 pilares del contenido de calidad.
Si le das a un botón para generar automáticamente miles de páginas, el esfuerzo requerido para generar cada una de esas páginas tiende a cero. Tampoco podrás demostrar que ha habido originalidad, talento o habilidad por tu parte, o que el contenido es exacto (si ni siquiera sabes lo que dicen esas páginas).
Tratar de arreglar el problema firmando el contenido o, peor aún, creando una identidad falsa o inexistente para que lo firme por ti, no es una solución, sino que lo convierte en un problema más grave.
Gracias al resumen de John Campbell de la intervención del googler Duy Nguyen en el reciente evento Search Central Live en Barcelona, sabemos que el inusitado número de updates de spam de este año (llevamos 4 ya), se debe a que Google cada vez se enfrenta a cantidades mayores de contenido generado por IA (como no podía ser de otra forma).
Como he dicho y ha ocurrido en otras ocasiones, puede parecer que la respuesta por parte de Google al alud de contenido generado por IA está tardando, o que no es aún del todo efectiva… hasta el momento en el que llega un update que sí lo es.
En mi opinión, todos estos cambios a la documentación podrían ser un preludio a un update con efectos más devastadores contra el contenido generado por IA y de poca calidad, de acuerdo a los criterios que llevan tiempo anunciando desde su guía de evaluadores y que ahora han dejado diáfanamente claros en su documentación.
Sólo puedo cerrar el post diciendo por tercera vez: a buen entendedor…
Muy top el post. En realidad es sentido común, pero como nos gusta trampear y escalar posiciones de forma rápida u obtener resultados con el mínimo esfuerzo, pues… acaba pasando lo que pasa. Penalizaciones. Luego está que cada vez es más difícil demostrar que alguien es experto en un tema. Antes a nada que se escribía se veía si dominaba o no, pero ahora con la IA todo el mundo es experto en todo y para demostrar que realmente eres experto tienes que aportar datos u opiniones que estén fuera de las IAs…